文生视频的提示词要按镜头写,而不是按故事写。一条能用的提示词通常包含四层:谁在做什么、镜头怎么动、画面什么质感、这一段持续多久。四层写全,画面跑偏会少很多。
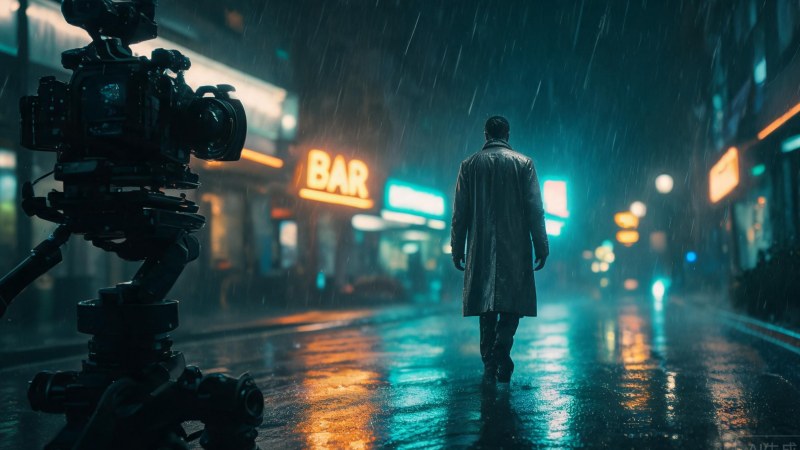
模型对「一个人很孤独」这种情绪描述几乎没有反应,对「穿灰色风衣的男人站在雨夜的便利店门口,低头点烟」这种能拍到的画面反应很快。所以第一层只写三件事:主体是谁、正在做什么动作、处在什么环境。主体尽量具体到服装和年龄,动作只写一个主要动作加一个细微动作,环境写清地点与时间。如果画面里有两个以上的人,要明确谁在前景、谁在背景,否则模型容易把人合并成一个。动作也不要写「然后」「接着」这类连续动作,一个五秒镜头只承载一个动作,后续动作交给下一个镜头,写之前先想清楚这一帧要停在哪。
运镜决定了视频是真正动起来,还是像一张会呼吸的照片。常用的六种可以写得很直白:推镜头靠近主体,适合强调表情和细节;拉镜头后退,适合交代环境;摇镜头左右转动,适合展示全景;移镜头平行横移,适合跟随街道或货架;跟镜头跟着主体移动,适合走路和奔跑;升降镜头改变高度,适合建筑与开场。写的时候用「镜头缓慢推近」这样的自然语言,比英文术语更容易被理解。一条提示词只给一种运镜,同时要求推近又环绕,模型往往两边都做不好,画面会抖,镜头运动宁可简单也不要复杂,稳定比花哨重要。
同样一句「咖啡店里的女孩」,加不加光线词是两幅画面。光线可以写方向与色温,比如「侧逆光、暖黄台灯、窗外冷蓝暮色」;材质可以写「皮肤有细微毛孔、毛衣是粗针织」;风格可以写「三十五毫米胶片质感、浅景深、轻微颗粒」。三层各写一句就够,写太多会互相打架,其中光线对观感的影响最大,值得多试两遍。还要加一句负面约束,比如「画面稳定、不出现文字、不出现多余手指」,这几个问题在人物特写里出现频率最高。想让多段视频风格统一,就把这一层原样复制到每一条提示词里,只改前两层,整片看下来才像一个系列。
主流文生视频单段时长多在五到十秒,时间很短,信息密度反而要低。一个五秒镜头按「起、承、转」安排:前一秒半建立画面,中间两秒完成主要动作,最后一秒半留给表情或环境收尾。如果要讲一个完整情节,就拆成三到四个镜头,每个镜头只负责一个动作,再在剪辑里用同一色调和同一运镜方向串起来。常见错误是把「走进门、坐下、点单、抬头微笑」全写进一条提示词,结果模型只完成了第一个动作,后面的动作变成画面抖动。
雨夜的便利店门口,穿灰色风衣的年轻男人低头点烟,手部动作缓慢;镜头从胸口高度缓慢推近到侧脸特写;侧逆光,霓虹反光落在雨地上,三十五毫米胶片质感,浅景深,轻微颗粒;画面稳定,不出现文字,不出现多余手指。
生成后先看三处:主体有没有变形,运镜方向对不对,最后一帧能不能接上下一个镜头。三处都没问题,再延长时长或换机位重拍,比一次写十条提示词更省时间。
建议先固定光线和风格这一层,只改主体与运镜,连续生成四条同一场景的镜头,再挑能接上的两条。需要现成的文生视频入口,可以打开极客空间站的 AI 视频页面,把上面这套四层句式填进去即可。截至 2026 年 11 月,单段五秒仍是多数模型最稳的生成长度,长片更适合分镜后再剪。
相关内容推荐
先写光源位置和时段,再补一句色温与主色,AI 视频的画面就会从灰扑扑变得有氛围。整批素材沿用同一句光线描述,拼接时色调也更统一,少用「氛围感」这类抽象词,先定光...
风格由内容描述开头的风格短语决定。写实靠材质、光线、镜头三个锚点,动画靠概括造型和大色块。先定风格再写内容,多段素材重复同一短语,质感才统一,风格短语放第一句权...
人物要写得住,靠一个明确动作加一个幅度词。再补视线和可看见的表情细节,手部保持相对静止,10 到 15 秒的人物画面就不容易僵硬或崩坏,描述越具体越听话,多人画...
画面抖动多半来自运动叠加、动作与时长不匹配、参考图与描述冲突。先分清是抖动、闪烁还是变形,按描述、参数的顺序排查,每次只改一项再生成,比同时调整多个参数更快找到...
大连极客十一维科技有限公司